博客
 1 开头的数字为什么占三成:本福特定律,和它抓假账的本事日期: 2026-10-23现在给你 60 秒,在纸上编 100 个"随机数"。写完之后数一下首位数字——你大概会写出 11 个 1、11 个 2……每个数字差不多一样多。但真实世界不是这么干的:河流长度、股票价格、人口、文件大小、你硬盘上 40 万个文件的字节数,里面 1 开头的占 30.1%,9 开头的只有 4.6%。这不是巧合,它精确到小数点后三位:log10(1+1/d)。1881 年天文学家 Newcomb 发现图书馆里对数表的前几页被翻得最脏,1938 年 Benford 收集了 20229 个数字把它写下来。我把它从头跑了一遍:为什么 2 的 n 次方完美符合而素数几乎均匀(1 开头的素数只有 11.9%,而且范围越大越向 11.1% 靠拢)、为什么身高用厘米记就 100% 是 1、为什么跨 1.2 个数量级的诚实数据会被 100% 误判成造假、以及最实用的那个——账本里掺 10% 的假数字,要多少条记录才能有九成把握抓到(答案是 5000 条)。
 下划线排第三:键盘布局是给英文散文设计的,可我们打的是代码日期: 2026-10-23August Dvorak 说过一句被引用了九十年的话:同一段文字,在 QWERTY 上打字员的手指要走 20 英里,在他的布局上只走 1 英里。我拿系统里真实的键盘布局定义(/usr/share/X11/xkb/symbols/us)和 7000 万字符的真实语料测了一遍:写这个博客的 63 万个字符,QWERTY 走了 15.9 公里,Dvorak 走了 14.8 公里,省下 6.67%,不是 20 倍。更要紧的是另一件事——所有替代布局的优化目标都是英文散文,而 C 语言里第三常用的字符是下划线(44.6‰),比 i、n、r、a 都高,英文散文里它只有 1.65‰。我用模拟退火分别为英文、JavaScript、C 各优化出一个布局,再把它们交叉评估:为错误语料做优化的代价是 7.6%~12.0%,和换成 Dvorak 能拿到的全部收益是同一个量级。
 前面什么都没有,为什么还是走不动:幽灵堵塞的账日期: 2026-10-22堵了二十分钟,终于挪到"堵点",然后你发现——前面什么都没有。没有事故,没有施工,没有并道,路是空的。这不是错觉,它有个名字:幽灵堵塞。2008 年日本学者把 22 辆车开上一圈 230 米的环形跑道,要求所有人保持 30 km/h 匀速,没有出口没有信号灯,几十秒后车流自己分成了"跑得动的"和"跑不动的"两段。我用一个叫 NaSch 的元胞自动机把这事儿复现了一遍:7.5 公里长的环路、从完美均匀的队形出发、关掉所有随机性,车流稳稳跑在 135 km/h,300 秒一个人都没停;只要打开"每个司机每秒有 30% 概率慢一档"这一个开关,第 19 秒就出现了第一辆停死的车。密度 8 辆/km 的路上,一个人踩两秒刹车,把"会不会有人停死"的概率从 2% 拉到 55%。堵塞会以 10~16 km/h 向后传播,也就是说,你等的那个堵点,正在朝你走过来。
 格陵兰没有那么大:一张 1569 年的航海图,还挂在你手机里日期: 2026-10-20非洲的真实面积是格陵兰的 14.02 倍,但你在 Google Maps 上看到的格陵兰比整个非洲还大 16%。这一切源自 1569 年墨卡托的一张航海图:纬度 φ 处的面积被放大 sec²φ 倍,60°N 放大 4 倍,80°N 放大 33 倍,85°N 放大 132 倍。Web Mercator 把世界裁成一张 40075 km 的正方形,面积恰好是地球表面积的 π 倍,南极 6.8% 被直接切掉。我用两个脚本复算了这些数字:格陵兰在墨卡托上平均被放大 15.5 倍,中国 1.56 倍,非洲只有 1.11 倍。顺手算清了前端最常踩的那个坑——EPSG:3857 里的"米"在 60°N 只剩半米,z=12 上画一个 1km 的圆,北京要 34 像素,赤道只要 26 像素。
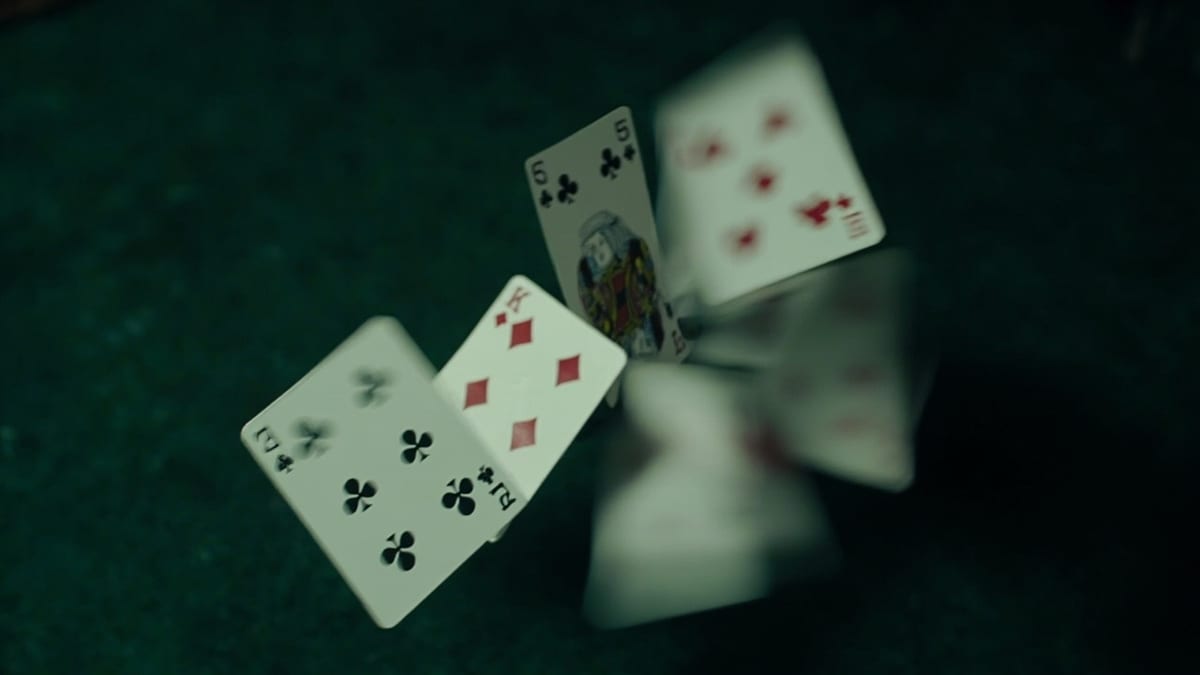 洗七次才洗开:一副扑克牌的随机性断崖日期: 2026-10-19一副 52 张的扑克牌,riffle shuffle 洗 4 次和没洗几乎没区别——洗 4 次之后牌堆与"完全随机"的总变差距离仍然是 0.9999995,洗 3 次以内则精确等于 1。第 5 次才开始松动(0.9237),第 6 次 0.6136,第 7 次 0.3341,第 8 次 0.1672,之后每多洗一次距离精确减半。我用 BigInt 精确复算了 Bayer & Diaconis 1992 年那张表:洗 1 次之后,最上面那张牌还有 49.75% 的概率仍在最上面(随机是 1.92%,26 倍),51 对原相邻牌里还有 25.51 对挨在一起,整副牌只有 2 个"上升序列"——也就是两摞牌交错了一下。而完美 faro 洗牌能在 8 次内把 52 张牌洗回原样;一旦加进两张大小王变成 54 张,这个数字跳到 52 次。切牌洗一万次也洗不开(只有 52 种排列)。印度洗牌要洗 50~100 次才追上 riffle 洗 7 次的效果。
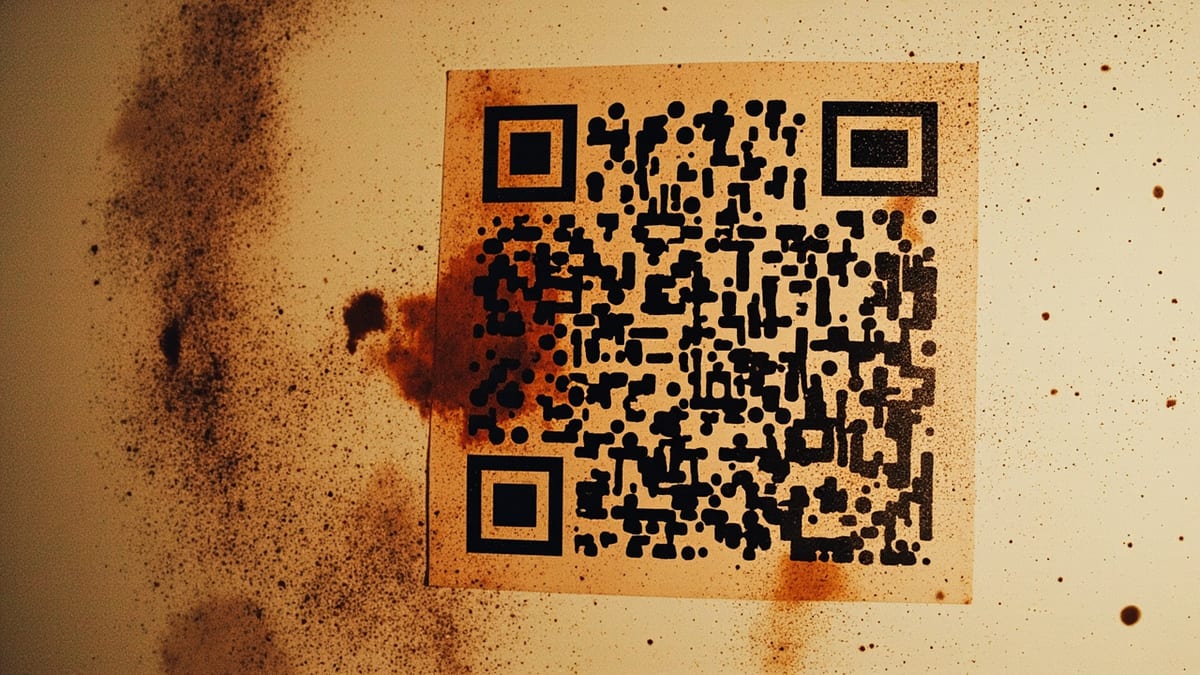 二维码说能恢复 30%,前提是墨水别撒开日期: 2026-10-18我在 Node 里生成了几万个二维码,再一个个涂坏丢给解码器:一个码字是 8 个小方块,坏 1 个和坏 8 个代价完全一样(v40-H 实测 723 vs 703 个码字);同样数量的坏方块,撒在整张图上只能扛 0.79%~2.52%,挤成中心一整块却能扛下 8.3%~26.4% 的面积——v40 的 H 级,791 个方块撒开就有一半扫不出来,784 个挤成 28×28 却稳稳扫出。流传的「H 能恢复 30%」说的是码字(v40-H 纠错码字占 65.6%,可纠 1215 个),换算成你眼睛看到的小方块,随机撒开时上限只有 2.52%。另外,等级从 L 提到 H,同一段内容会从 33×33 涨到 45×45,打印成 2 厘米见方时每个方块从 0.606mm 缩到 0.444mm。全部数字来自本机 Linux x86_64、Node v24.16.0,qrcode 生成 + jsQR 解码。
 钢琴是走音的:一场持续两千年的数学妥协日期: 2026-10-17钢琴上的 C 大三和弦是 261.63 / 329.63 / 392.00 Hz,而物理上真正"对齐"的是 261.63 / 327.03 / 392.44 Hz——中间的 E 高了 2.6 Hz,也就是 13.69 音分。这不是钢琴没调好:纯律的 11 个音程里,十二平均律有 6 个偏离超过 10 音分,大六度偏了 15.64 音分。我用代码算了一遍:五度相生律绕 12 个纯五度回到原点会多出 23.46 音分(毕达哥拉斯音差),而 1~60 等分里比 12 等分更准的有 9 个(53 等分误差只有 1.41 音分)。平均律赢的原因从来不是"更准",而是"每个调都一样不准"——它把误差摊平,换来了任意转调的自由。另外真实钢琴比平均律还要再"走"一次:弦的非谐性让高音区的八度被拉宽到 1207.80 音分。
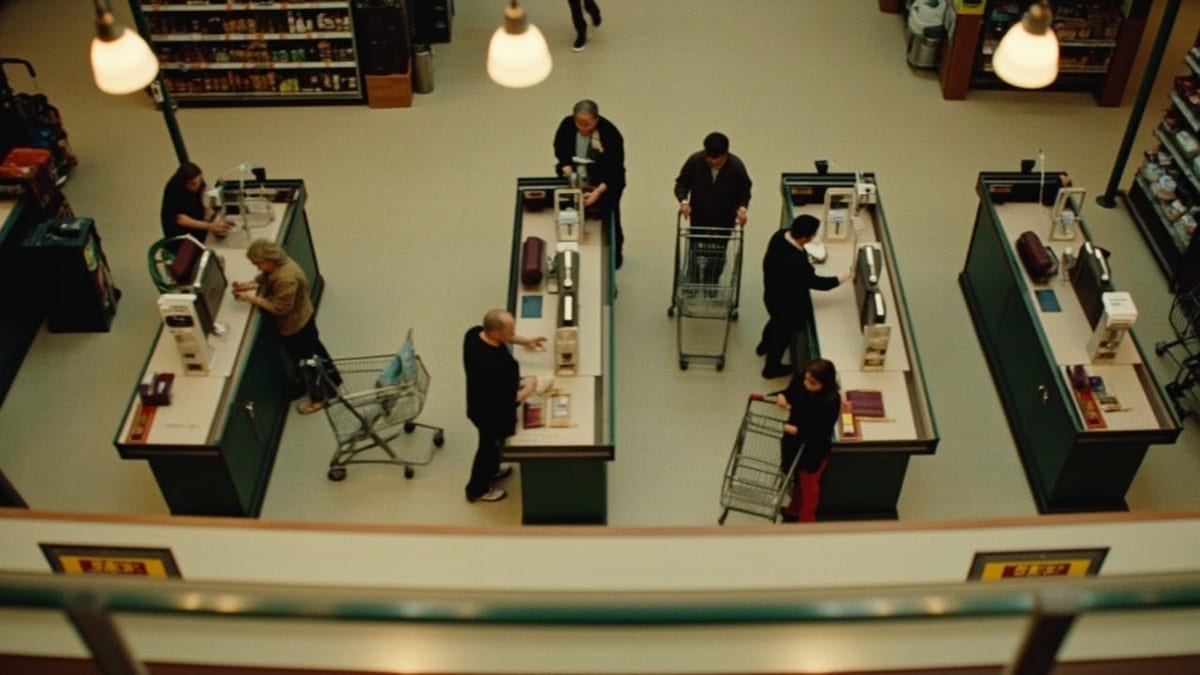 你排的那一队,凭什么总是最慢的日期: 2026-10-16我在 Node 里模拟了 20 万个人排队:5 条队时,随机时刻你这条队是全场最快的概率只有约 13%,69.14% 的时刻至少有一条队比你快;而如果你只在"自己这条队 20 秒没动静"时才抬头看隔壁,这个比例会升到 76.74%,这类时刻占你整个等待时间的 75.79%。把 5 条队合并成一条蛇形队,平均等待从 312.3 秒降到 44.7 秒(-85.69%),标准差从 362.9 降到 62.7,但基尼系数反而从 0.58 升到 0.67。ρ 从 0.5 涨到 0.98 不到一倍,平均等待从 3.2 秒涨到 501.0 秒——157 倍。"10 件以下"快通道把 40% 的人推到负载 1.16 的普通道上,大车等待发散到 49524.9 秒。把所有人的服务时间都压成 60 秒,效果等价于让每个人平均快 13%。所有数字来自本机 Linux x86_64、Node v24.16.0 的离散事件模拟。
 0.1 + 0.2 不等于 0.3:我把浮点数的账算了一遍日期: 2026-10-15一笔 54.03 元的订单,用整数分重算一遍是 54.02——差一分钱。Node v24.16.0 实测:0.1 存进内存后其实是 0.1000000000000000055511151231257827021181583404541015625,1/10 的二进制是 0.0001100110011…(循环节 0011,永远写不完);0.1+0.2 的结果与 0.3 之间正好隔着 1 个 ULP,nextAfter(0.3) 恰好就是 0.1+0.2;加法结合律不成立——[1e16, 1×9] 顺序求和得 10000000000000000,升序求和才得 10000000000000008;100 万个 0.1 朴素累加偏差 1.33e-6 而 Kahan 补偿求和偏差为 0 且几乎不花时间;2^53+1 === 2^53,雪花 ID 1837468647967162368 经 JSON.parse 变成 1837468647967162400;(1.005).toFixed(2) 是 "1.00" 而 Intl 给 1.01,20 万个三位小数里末位为 5 的有 20807 个,其中 9755 个(46.88%)被 toFixed 舍错方向;位运算把 1e10 截成 1410065408、把 MAX_SAFE_INTEGER 截成 -1;JSON.stringify(-0) 是 "0"。所有数字来自本机 Linux x86_64、Node v24.16.0 实测。
 Promise.all 里一个任务失败后,另外 20 个还在干什么:我把并发与取消的账算了一遍日期: 2026-10-14一个批处理接口在第 30.3ms 已经 catch 到错误,另外两个任务却继续跑到 80.5ms 和 120.6ms——Promise.all 的 fail-fast 只是不再等结果,不是让剩余工作 fail-stop。Node v24.16.0 实测:20 个 100ms 任务直接 Promise.all,100.4ms 跑完但峰值并发就是 20;限制并发为 4 后需要 501.1ms,峰值也精确降到 4;20 个可取消任务中一个在 50ms 失败,不传 signal 时另外 20 个全部完成,catch 后调用 AbortController.abort() 则完成 0、取消 20;Promise.race 在 20.1ms 选出赢家,100ms 的输家照样产生副作用;fetch 在 54.7ms 被取消、连接在 55.4ms 关闭,但服务端工作仍跑到 309.6ms。顺便算清结果顺序、后续 rejection、AbortSignal.timeout/any、监听器清理,以及怎样写一个真正会停下来的任务组。所有数字来自本机 Linux x86_64、Node v24.16.0 实测。